
عندما تحوّل الـ Failover من وسيلة للحماية إلى سبب في توقف GitHub وكشف مستودعات خاصة على GitHub
تخيّل أنك تعمل على منصة يستخدمها ملايين المطورين حول العالم، وتعتمد على قاعدة بيانات واحدة لتخزين معلومات المستخدمين ومستودعات الأكواد (Repositories).
ماذا سيحدث إذا تعطّل خادم قاعدة البيانات؟ سيتوقف التطبيق عن الوصول إلى البيانات، وقد تتوقف الخدمة بالكامل.
لحل هذه المشكلة، يمكننا الاحتفاظ بنسخة من قاعدة البيانات على خادم آخر، بحيث نتمكن من الاعتماد عليه إذا تعطل الخادم الرئيسي.
لكن ماذا لو قرر النظام الانتقال إلى الخادم البديل رغم أن الخادم الرئيسي لم يتعطل بالفعل؟
هذا ما حدث مع GitHub في سبتمبر 2012، عندما تعرضت لانقطاع في الخدمة استمر ساعة و46 دقيقة، أعقبه وقت آخر من الأداء المتدهور بشكل ملحوظ، وأدي إلى كشف مستودعات خاصة (private)
دعنا نفهم كيف حدث ذلك، بدءًا من المفاهيم الأساسية التي اعتمدت عليها البنية.
أولًا: لماذا نحتاج إلى Replication؟
عندما يعتمد التطبيق على خادم قاعدة بيانات واحد، يصبح هذا الخادم نقطة فشل واحدة (Single Point of Failure). فإذا تعطل، قد تتوقف الخدمة بالكامل.
هنا يأتي دور Replication، وهي عملية الاحتفاظ بنسخ من البيانات على أكثر من خادم، بهدف تحسين التوافر (Availability)، كما يمكن استخدامها لتوزيع أحمال القراءة (Read Load).
إحدى الطرق الشائعة لتنفيذها هي Master-Slave Replication.
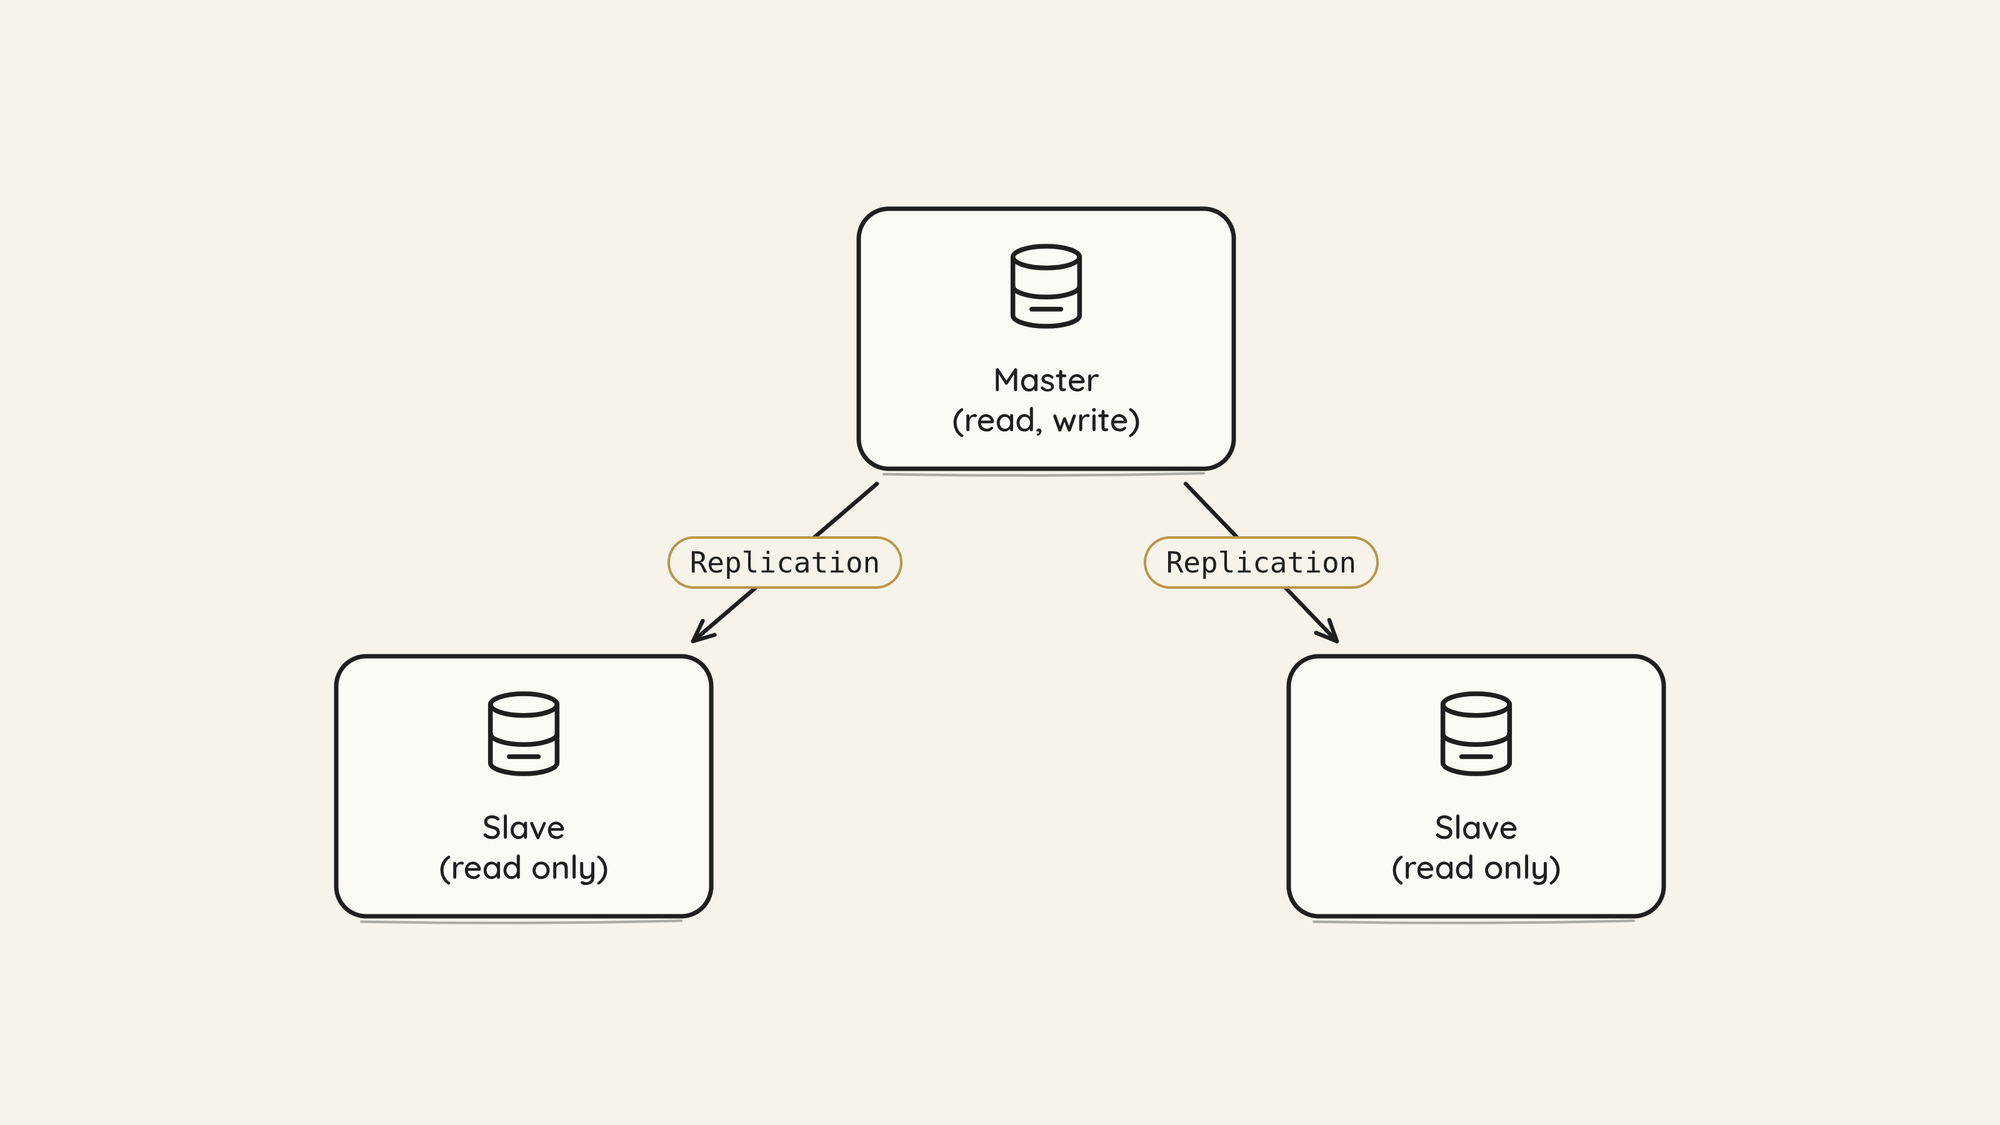
في هذا النموذج، يكون الـ Master مسؤولًا عن استقبال عمليات الكتابة (Writes)، ويمكنه استقبال عمليات القراءة (Reads) أيضًا، بينما تحتفظ خوادم الـ Slaves بنسخ من بياناته، ويمكن استخدامها لعمليات القراءة.
لكن في كثير من الأنظمة، تتم عملية Replication بشكل غير متزامن (Asynchronous)، أي أن الـ Master قد ينتهي من الكتابة قبل وصول التحديث إلى الـ Slave.
هذا التأخير يُعرف باسم Replication Lag، وقد يؤدي إلى قراءة بيانات قديمة من الـ Slave.
أما إذا تعطل الـ Master، فيمكن نقل دوره إلى أحد الـ Slaves من خلال عملية تُسمى Failover.
لكن هذه العملية ليست خالية من المخاطر؛ فقد يكون الخادم البديل متأخرًا في استقبال البيانات، أو غير مستعد لتحمّل الحمل، أو قد تحدث مشكلة تجعل أكثر من خادم يعتقد أنه الـ Master.
وهذه المخاطر تحديدًا كانت جزءًا من قصة GitHub.
ثانيًا: البنية الجديدة لـ GitHub
في منتصف أغسطس 2012، استبدلت GitHub خادمي MySQL القديمين، اللذين كانا يعتمدان على DRBD، ببنية جديدة تتكون من ثلاثة خوادم.
في البنية القديمة، كان الانتقال من خادم قاعدة بيانات إلى آخر يتطلب إعادة تشغيل MySQL، وهو ما كان يجعل الـ Failover أبطأ.
أما في البنية الجديدة، فكانت MySQL تعمل على الخوادم الثلاثة طوال الوقت، وكان من الممكن نقل الدور الرئيسي بينها باستخدام عناوين IP افتراضية (Virtual IPs)، مع تغيير إعدادات قاعدة البيانات المناسبة.
اعتمدت البنية على ثلاثة مكونات رئيسية:
- الPacemaker وHeartbeat: لإدارة الـ Cluster ومراقبة حالة الخوادم وتنسيق العمليات بينها.
- ال Percona Replication Manager: لإدارة أدوار الـ Master والـ Slave والتنسيق مع Pacemaker.
- ال Virtual IPs: لتوفير عناوين ثابتة يستخدمها التطبيق للوصول إلى قاعدة البيانات.
كان الهدف هو جعل الانتقال بين الخوادم أسرع، دون الحاجة إلى إعادة تشغيل MySQL في كل مرة.
لكن سرعة الانتقال لا تعني بالضرورة أن الخادم البديل مستعد لاستقبال الحمل.
ثالثًا: الاثنين 10 سبتمبر — عندما أصبح الضغط عطلًا
بدأت المشكلة بعملية عادية لتحديث مخطط قاعدة البيانات (Database Migration).
كانت GitHub تستخدم نظامًا من مرحلتين (Two-Pass Migration)، يسمح بإجراء تغييرات على الـ Schema دون إيقاف الخدمة.
لكن هذه المرة، تسببت عملية الـ Migration في حمل أعلى من المعتاد على قاعدة البيانات، مما أدى إلى فشل فحوصات الصحة (Health Checks) التي ينفذها Percona Replication Manager على الـ Master.
هذه الفحوصات مصممة للتأكد من أن الخادم يعمل بصورة طبيعية. وعندما فشلت، اعتبر النظام أن الـ Master قد تعطل، وبدأ عملية Failover تلقائية.
انتقل الدور الرئيسي إلى خادم آخر، لكن هذا الخادم كان يعاني من مشكلة: ذاكرة InnoDB المؤقتة (InnoDB Buffer Pool) لديه كانت باردة (Cold)، أي أنها لم تكن تحتوي على البيانات الأكثر استخدامًا.
لذلك، عندما بدأ في استقبال طلبات الموقع، اضطر إلى قراءة كميات كبيرة من البيانات من القرص، مما أدى إلى تراجع أدائه.
ومع ارتفاع الحمل، فشلت Health Checks على الخادم الجديد أيضًا، فعاد النظام بنقل الدور الرئيسي إلى الخادم الأصلي.
أصبح لدينا الآن عمليات Failover متكررة، وكل انتقال يتسبب في تحميل خادم غير مستعد بالحمل الكامل.
لإيقاف هذه الحلقة، قرر فريق العمليات تفعيل وضع maintenance-mode في Pacemaker، وهو وضع يمنع تنفيذ الفحوصات وإجراءات الـ Failover التلقائية.
وبمرور الوقت، تحسن أداء الموقع مع امتلاء الـ Buffer Pool بالبيانات المطلوبة.
لكن إيقاف الأتمتة (automation) لم يُنهِ المشكلة، بل مهّد لظهور مشكلة أخرى في اليوم التالي.
رابعًا: الثلاثاء 11 سبتمبر — عندما أصبحت المشكلة في البيانات
في صباح اليوم التالي، أبلغ أحد المطورين عن ظهور نتائج غير صحيحة من الخادم الذي يؤدي دور الـ Standby.
بعد التحقيق، اكتشف الفريق أن تفعيل maintenance-mode منع تنفيذ بعض الإجراءات الضرورية، ومنها تغيير مصدر الـ Replication للخادم الذي اختير ليكون الـ Standby.
قرر الفريق إلغاء maintenance-mode حتى يتمكن Pacemaker وPercona Replication Manager من تصحيح حالة الـ Cluster.
لكن أثناء هذه المحاولة، تعرض Pacemaker لخطأ برمجي يُعرف باسم Segmentation Fault (Segfault)، أدى إلى انقسام الـ Cluster إلى مجموعتين منفصلتين، وهي حالة تُسمى Cluster Partition.
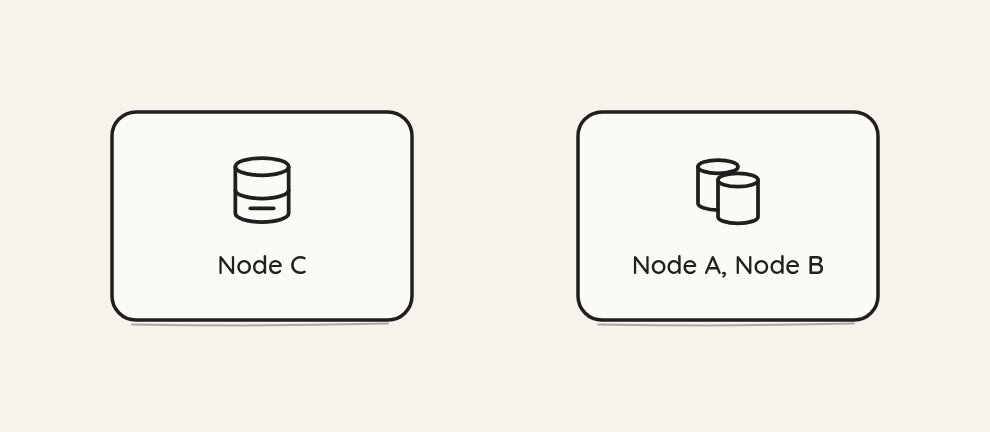
رغم أن النظام كان مُعدًّا لاشتراط موافقة الأغلبية (Majority) قبل اتخاذ القرارات، حدثت محاولتان متزامنتان لانتخاب الـ Master دون التنسيق المطلوب.
في المجموعة التي تضم A وB، تعطلت عملية الانتخاب وتوقفت MySQL.
أما المجموعة التي تضم العقدة C وحدها، فقد انتُخبت لتصبح الـ Active في الساعة 8:19 صباحًا.
لكن كانت هناك مشكلة خطيرة: العقدة C هي نفسها التي اكتشف الفريق في اليوم السابق أنها لا تحتوي على أحدث البيانات.
عندما اكتشف الفريق ذلك، قرر إيقاف العقدة C في الساعة 8:26 صباحًا لمنع استمرار اختلاف البيانات (Data Drift).
لكن إيقافها أدى إلى توقف الوصول إلى جميع قواعد بيانات الإنتاج، وبالتالي توقف GitHub.com.
كيف تحولت المشكلة إلى تسريب بيانات؟
لم يتوقف تأثير الحادثة عند انقطاع الخدمة.
كانت GitHub تستخدم MySQL إلى جانب Redis، الذي يُستخدم للوصول إلى بعض بيانات أحداث لوحات المستخدمين (Dashboard Event Streams) ومسارات المستودعات (Repository Routes)، بالاعتماد على معرّفات (IDs) تُنشأ في MySQL.
أدى اختلاف البيانات بين الأنظمة إلى احتمال عدم تطابق هذه المعرّفات، وبالتالي أصبحت بعض العلاقات بين البيانات غير صحيحة.
ونتيجة لذلك، ظهرت بعض الأحداث على لوحات مستخدمين غير أصحابها، كما وُجّهت بعض المستودعات بشكل خاطئ.
بعد مراجعة الحادثة، اكتشفت GitHub أن 16 مستودعًا خاصًا (Private Repositories) أصبحت متاحة لأشخاص من خارج قائمة المصرح لهم لمدة سبع دقائق، من 8:19 إلى 8:26 صباحًا.
أزالت GitHub الأحداث التي تسربت، وراجعت المستودعات المتأثرة، وتواصلت مباشرةً مع أصحابها.
وهكذا تحولت مشكلة بدأت بضغط على قاعدة البيانات، إلى مشكلة أثرت على توافر الخدمة، ثم على سلامة البيانات وسريتها.
خامسًا: استعادة الخدمة
بعد إيقاف العقدة C، بدأ الفريق في استعادة حالة الخادمين A وB.
لكن محاولات تعديل حالة الـ Cluster لم تنجح، لذلك قرر الفريق إعادة تشغيل Pacemaker للحصول على حالة نظيفة.
أوقف الفريق عمليات Pacemaker وHeartbeat على الخادمين، ثم أعاد تشغيلها على العقدة A أولًا.
تمكنت MySQL من العمل على الخادم A واستعادة دور الـ Active، وبدأ أداء الموقع يتحسن تدريجيًا مع امتلاء الـ Buffer Pool.
وفي الوقت نفسه، واجهت صفحة الحالة (Status Page) التي كانت GitHub تستضيفها على Heroku مشكلة مستقلة.
مع زيادة عدد المستخدمين الذين يحاولون معرفة حالة GitHub، رفع الفريق عدد وحدات التشغيل (Dynos) من 8 إلى 64 ثم إلى 90.
لكن قاعدة البيانات المشتركة القديمة التي كانت تعتمد عليها صفحة الحالة لم تستطع تحمّل الاتصالات الإضافية، مما أدى إلى تعطل بعض العمليات.
وبالتعاون مع دعم Heroku، شغّل الفريق قاعدة بيانات إنتاجية قادرة على تحمّل الحمل، فتحسن أداء صفحة الحالة.
وبعد الحادثة، أضافت GitHub نسخة تابعة (Database Slave) لتحسين خيارات التوافر مستقبلًا.
سادسًا: ماذا تعلمت GitHub من الحادثة؟
بعد تحليل ما حدث، حددت GitHub ثلاثة أسباب رئيسية ساهمت في الانقطاع:
- حدوث عمليات Failover متكررة لم تكن ضرورية.
- انقسام الـ Cluster، مما أدى إلى اتخاذ قرارات غير صحيحة.
- تأثير عمليات الـ Failover على الأداء والتوافر بصورة أكبر من المتوقع.
لكن أهم قرار اتخذته GitHub كان متعلقًا بالأتمتة.
فقد قرر الفريق تعديل إعدادات Pacemaker بحيث لا تحدث عمليات Failover للدور الرئيسي تلقائيًا، بل يجب أن يبدأها أحد أعضاء فريق العمليات.
كما بدأ الفريق في دراسة طرق لتهيئة الـ InnoDB Buffer Pool على الخوادم البديلة مسبقًا (Cache Warming)، لتقليل تأثير الانتقال على الأداء.
وأجرى أيضًا مراجعة شاملة لمنظومة Pacemaker وHeartbeat، مع التركيز على الخطأ البرمجي الذي تسبب في الـ Segfault، إلى جانب اختبارات مكثفة للأجهزة.
الخلاصة
صُممت البنية الجديدة في GitHub لتقليل زمن الـ Failover، لكنها كشفت أن سرعة الانتقال بين الخوادم وحدها لا تكفي لضمان التوافر.
فنجاح الـ Failover يعتمد على صحة البيانات، والتنسيق بين الخوادم، واستعداد الخادم البديل، وقدرة النظام على التمييز بين العطل الحقيقي والضغط المؤقت.
فالهدف من High Availability ليس مجرد وجود خادم بديل، بل ضمان أن انتقال المسؤولية إليه لن يتسبب في مشكلة أكبر من المشكلة التي نحاول تجنبها.
وهذا أحد المبادئ الأساسية في هندسة الأنظمة: كل آلية تضيفها لتحسين الاعتمادية (Reliability) قد تُدخل معها أنماطًا جديدة من الفشل، ويجب أن يكون تصميمك مستعدًا لها.