
تخيّل أنك تعمل على منصة يستخدمها ملايين المطورين حول العالم، وتعتمد على قاعدة بيانات لتخزين معلومات المستخدمين والمشروعات والتعليقات.
ماذا سيحدث إذا حذف أحد المهندسين بيانات قاعدة البيانات بالخطأ؟
قد تقول إن المشكلة بسيطة: نستعيد البيانات من النسخة الاحتياطية، ونعيد تشغيل الخدمة.
لكن ماذا لو اكتشفت أن النسخ الاحتياطية لم تكن تعمل منذ فترة، وأنك لا تملك نسخة حديثة يمكنك الاعتماد عليها؟
هذا ما واجهته GitLab يوم الثلاثاء، 31 يناير 2017، عندما أدى خطأ أثناء التعامل مع خوادم قواعد البيانات إلى حذف نحو 300 جيجابايت من بيانات الإنتاج.
استمر انقطاع الخدمة نحو 18 ساعة، ولم يتمكن الفريق من استعادة بعض البيانات التي فُقدت.
لكن كيف حدث ذلك؟ ولماذا لم تكن النسخ الاحتياطية كافية لإنقاذ الموقف؟
دعنا نفهم القصة، بدءًا من المفاهيم الأساسية التي اعتمدت عليها البنية.
1. لماذا نحتاج إلى خادم ثانٍ لقاعدة البيانات؟
تخيّل أن تطبيقك يعتمد على خادم PostgreSQL واحد.
إذا تعطل الخادم، فقد يفقد التطبيق القدرة على الوصول إلى البيانات، وقد تتوقف الخدمة بالكامل.
إحدى الطرق لتقليل هذا الخطر هي الاحتفاظ بنسخة من قاعدة البيانات على خادم آخر.
يُسمّى الخادم الأساسي Primary، بينما يُسمّى الخادم الثانوي Secondary.
تُستخدم عملية Replication لنقل التغييرات من الخادم الأساسي إلى الخادم الثانوي، بحيث يحتفظ الأخير بنسخة محدثة من البيانات.
وإذا تعطل الخادم الأساسي، يمكن تحويل العمل إلى الخادم الثانوي. وتُسمّى هذه العملية Failover.
لكن وجود خادم ثانٍ لا يعني بالضرورة أنك تستطيع استعادة بياناتك في كل الظروف. فالنسخ المتماثل يُستخدم عادةً لتوفير نسخة جاهزة لاستمرار الخدمة، لكنه ليس بديلًا كاملًا عن النسخ الاحتياطية.
وهنا نصل إلى نقطة مهمة في قصة GitLab.
كانت GitLab.com تعتمد على خادم أساسي واحد، اسمه db1.cluster.gitlab.com، وخادم ثانوي في وضع الاستعداد الساخن (Hot Standby)، اسمه db2.cluster.gitlab.com.
كان دور الخادم الثانوي الأساسي هو الاستعداد لاستلام العمل عند تعطل الخادم الأساسي، وليس توزيع الحمل بين الخادمين.
وفي يوم 31 يناير 2017، كان أحد المهندسين يعمل على إعداد عدة خوادم PostgreSQL في بيئة الاختبار (Staging)، لتجربة أداة pgpool-II التي يمكنها توزيع استعلامات قاعدة البيانات بين عدة خوادم.
كانت الخطة تهدف إلى تخفيف الحمل على قاعدة البيانات.
لكن ما حدث لاحقًا كشف أن المشكلة لم تكن في توزيع الحمل وحده.
2. الثلاثاء، 31 يناير 2017 — الساعة 17:20 UTC
قبل بدء العمل على بيئة الاختبار، أنشأ المهندس لقطة من قاعدة بيانات الإنتاج باستخدام LVM Snapshot، ثم نقلها إلى بيئة الاختبار حتى يتمكن من إجراء اختبارات على بيانات حديثة.
كان هذا الإجراء يُنفّذ عادةً مرة كل 24 ساعة، عند الساعة 01:00 UTC، لكن المهندس احتاج إلى نسخة أحدث من البيانات.
في ذلك الوقت، لم يكن هناك ما يشير إلى أن هذه الخطوة ستصبح لاحقًا وسيلة استعادة البيانات الوحيدة المتاحة للفريق.
3. الساعة 19:00 UTC — ارتفاع الحمل على قاعدة البيانات
بدأت GitLab.com تعاني من ارتفاع ملحوظ في الحمل على قاعدة البيانات.
اشتبه الفريق في أن السبب هو نشاط مزعج (Spam)، خصوصًا أن المنصة كانت قد واجهت مشكلات مشابهة خلال الأسبوع السابق، وإن لم تكن بهذه الشدة.
أثّر ارتفاع الحمل على المستخدمين؛ إذ لم يتمكن كثير منهم من نشر التعليقات على Issues وMerge Requests.
واستغرق الأمر عدة ساعات للسيطرة على الحمل.
لكن التحقيق اللاحق كشف عن عامل إضافي.
كانت هناك مهمة خلفية تحاول حذف حساب أحد موظفي GitLab والبيانات المرتبطة به، بعدما أُدرج حسابه بالخطأ ضمن إجراءات التعامل مع بلاغ إساءة استخدام.
إذن، لم يكن ارتفاع الحمل مرتبطًا بالنشاط المزعج وحده؛ بل ساهمت فيه أيضًا عملية حذف بيانات كان من المفترض ألا تُنفّذ بهذه الطريقة.
وهذا مثال على كيفية تفاعل عدة أحداث داخل النظام لتنتج مشكلة أكبر من كل حدث بمفرده.
4. الساعة 23:00 UTC — توقف النسخ المتماثل
بسبب ارتفاع الحمل، بدأ الخادم الثانوي يتأخر في مواكبة التغييرات التي تحدث على الخادم الأساسي.
ولفهم ما حدث، نحتاج إلى معرفة مفهوم Write-Ahead Log (WAL).
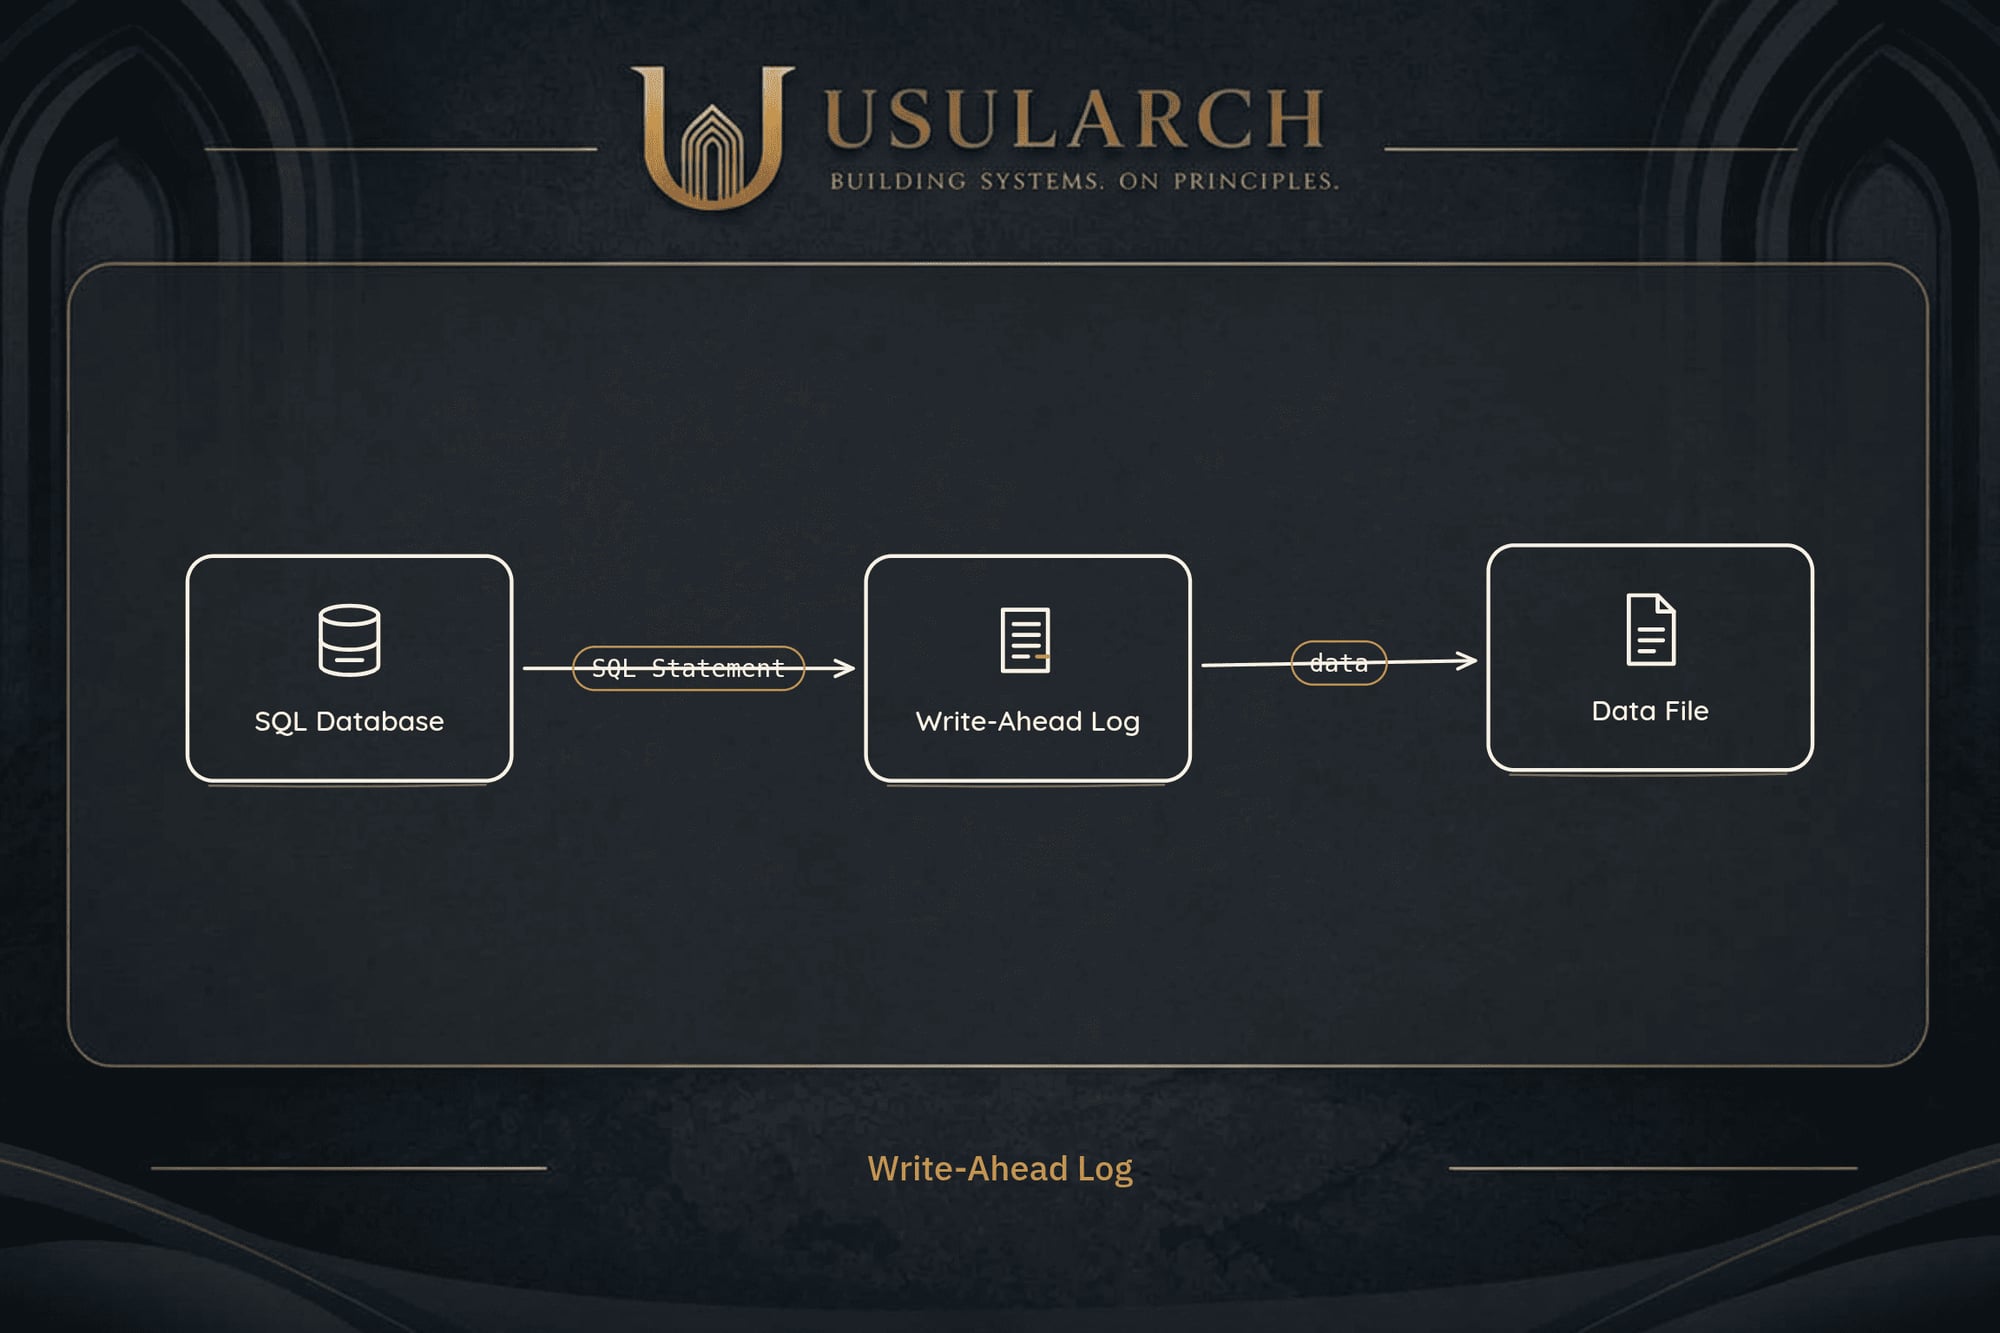
تستخدم PostgreSQL سجلات WAL لتسجيل تغييرات قاعدة البيانات، وتستفيد منها في الاستعادة والنسخ المتماثل.
كان الخادم الثانوي يحتاج إلى بعض سجلات WAL التي لم يتمكن من الحصول عليها؛ لأن الخادم الأساسي كان قد حذفها بالفعل.
ولأن GitLab.com لم تكن تستخدم أرشفة سجلات WAL، لم يعد بالإمكان استكمال النسخ المتماثل بالطريقة المعتادة.
كان الحل هو إعادة مزامنة الخادم الثانوي يدويًا.
تتطلب هذه العملية حذف مجلد البيانات الموجود على الخادم الثانوي، ثم استخدام أداة pg_basebackup لنسخ قاعدة البيانات من الخادم الأساسي.
بدأ أحد المهندسين تنفيذ هذه الخطوات، لكن أداة pg_basebackup كانت تنتظر دون إظهار معلومات مفيدة تشرح ما يحدث.
بعد عدة محاولات، ظهرت مشكلة في عدد اتصالات النسخ المتماثل المتاحة على الخادم الأساسي.
حاول الفريق تعديل الإعدادات لحل المشكلة، لكنه واجه مشكلة أخرى تتعلق بعدد الـ Semaphores، وهي موارد يستخدمها نظام التشغيل للتنسيق بين العمليات.
كان إعداد max_connections في PostgreSQL مضبوطًا على 8000، وهو رقم مرتفع جدًا بحسب تقرير GitLab. خفّض الفريق القيمة إلى 2000، ونجحت قاعدة البيانات في إعادة التشغيل، لكن المشكلة الأصلية لم تُحل.
استخدم أحد المهندسين أداة strace لمعرفة سبب انتظار pg_basebackup، لكن النتيجة لم تقدم تفسيرًا واضحًا.
وهنا أصبح غياب المعلومات الواضحة في أداة التشغيل والتوثيق عاملًا مؤثرًا في القرارات التالية.
5. الساعة 23:30 UTC — الخطأ الذي أدى إلى حذف بيانات الإنتاج
في هذه المرحلة، اعتقد أحد المهندسين أن محاولات تشغيل pg_basebackup السابقة ربما تركت ملفات داخل مجلد بيانات PostgreSQL على الخادم الثانوي.
قرر حذف المجلد مرة أخرى، ظنًا منه أنه يعمل على الخادم الثانوي.
لكن الأمر نُفّذ على الخادم الأساسي بدلًا منه.
لاحظ المهندس الخطأ، وأوقف العملية بعد ثانية أو ثانيتين من اكتشافه، لكن نحو 300 جيجابايت من البيانات كانت قد حُذفت بالفعل.
كيف أمكن أن يحدث ذلك؟
اتضح لاحقًا أن سلوك pg_basebackup كان طبيعيًا: فقد كانت الأداة تنتظر بدء الخادم الأساسي في إرسال بيانات النسخ، ولم تكن تُظهر معلومات واضحة عن هذا الانتظار.
لكن هذا السلوك لم يكن موضحًا بما يكفي في دليل التشغيل الداخلي أو في التوثيق الرسمي للأداة.
لم يكن المهندس متأكدًا مما يحدث، وحاول معالجة المشكلة بناءً على تفسيره للموقف.
وهكذا تحولت مشكلة في النسخ المتماثل، مع غياب معلومات تشغيلية واضحة، إلى حذف بيانات الخادم الأساسي.
لكن الكارثة لم تنتهِ عند هذا الحد.
كان الفريق بحاجة إلى استعادة البيانات، وهنا اكتشف أن وسائل الحماية المتاحة لم تكن تعمل كما ينبغي.
6. لماذا لم تنقذ النسخ الاحتياطية GitLab؟
كانت لدى GitLab عدة آليات لحماية بياناتها:
- نسخة احتياطية يومية باستخدام
pg_dump، تُرفع إلى Amazon S3. - لقطات LVM تُنشأ كل 24 ساعة، ثم تُنقل إلى بيئة الاختبار.
- لقطات لأقراص Azure على بعض الخوادم.
- نسخة ثانوية من قاعدة البيانات لاستخدامها عند التعطل.
لكن عندما حاول الفريق استعادة البيانات، اكتشف أن هذه الآليات لم توفر حلًا جاهزًا.
المشكلة الأولى: النسخ الاحتياطية لم تكن موجودة
عندما بحث الفريق عن النسخ الاحتياطية في Amazon S3، وجد أن الحاوية فارغة.
كانت عملية النسخ الاحتياطي تستخدم pg_dump الإصدار 9.2، بينما كانت قاعدة بيانات الإنتاج تعمل على PostgreSQL 9.6.
أدى اختلاف الإصدارات الرئيسية إلى فشل عملية النسخ الاحتياطي.
والأهم أن عملية النسخ كانت تُنفّذ على خادم تطبيق لا يحتوي على مجلد بيانات PostgreSQL الذي تعتمد عليه الحزمة لتحديد الإصدار الصحيح، ولذلك استخدمت الحزمة الإصدار 9.2.
المشكلة الثانية: رسائل الخطأ لم تصل
كان النظام مُعدًا لإرسال إشعارات بالبريد الإلكتروني عند فشل مهام النسخ الاحتياطي.
لكن رسائل البريد رُفضت بسبب مشكلة مرتبطة بإعدادات DMARC.
لم تصل التنبيهات إلى الفريق، ولم يكن هناك مسار بديل واضح للإبلاغ عن فشل عملية النسخ.
لذلك استمر فشل النسخ الاحتياطية دون أن يعرف الفريق بذلك، حتى وقع الحادث.
المشكلة الثالثة: لقطات Azure لم تكن مفعّلة
كانت GitLab تستخدم لقطات أقراص Azure على بعض الخوادم، لكنها لم تكن مفعّلة على خوادم قواعد البيانات.
افترض الفريق أن آليات النسخ الاحتياطي الأخرى كافية، خصوصًا أن استعادة لقطات Azure قد تستغرق وقتًا طويلًا في بعض الحالات.
المشكلة الرابعة: لقطات LVM لم تكن مصممة أساسًا للتعافي من الكوارث
كانت لقطات LVM تُستخدم بالأساس لنقل بيانات الإنتاج إلى بيئة الاختبار.
وكانت هناك لقطتان متاحتان وقت الحادث:
الأولى أُنشئت ضمن الإجراء الدوري قبل الحادث بنحو 24 ساعة.
والثانية أنشأها المهندس يدويًا عند الساعة 17:20 UTC يوم 31 يناير.
وبعد حذف البيانات من الخادم الأساسي، لم يعد بالإمكان الاعتماد على الخادم الثانوي أيضًا؛ إذ كان مجلد بياناته قد حُذف خلال محاولات إعادة النسخ المتماثل.
أصبح الخيار المتاح أمام الفريق هو استخدام اللقطة التي أُنشئت قبل الحادث بنحو ست ساعات.
وهنا تظهر المشكلة الحقيقية: لم تكن GitLab تفتقر إلى أدوات النسخ الاحتياطي فحسب، بل كانت تفتقر إلى مسار استعادة موثوق ومختبَر.
7. الأربعاء، 1 فبراير 2017 — استعادة قاعدة البيانات
قرر الفريق استخدام لقطة LVM التي أُنشئت عند الساعة 17:20 UTC في اليوم السابق، لتقليل كمية البيانات المفقودة.
لكن اللقطة كانت موجودة في بيئة الاختبار على أقراص Azure بطيئة، ولم تكن عملية نقل البيانات إلى الإنتاج سريعة.
اختار الفريق نقل مجلد بيانات PostgreSQL من بيئة الاختبار إلى خادم الإنتاج.
استغرقت عملية النقل نحو 18 ساعة ؛ لأن الأقراص كانت تعمل بسرعة منخفضة، وكان معدل النقل محدودًا بنحو 60 ميجابت في الثانية.
بعد ذلك، بدأ الفريق في استعادة قاعدة البيانات وإكمال الإجراءات اللازمة لإعادة الخدمة.
عند الساعة 17:00 UTC يوم 1 فبراير 2017، نجح الفريق في استعادة قاعدة بيانات GitLab.com، لكن دون بيانات Webhooks.
ولإعادة بيانات Webhooks، أنشأ الفريق قاعدة بيانات منفصلة باستخدام لقطة LVM، ثم استخرج البيانات المطلوبة منها وأدخلها إلى قاعدة البيانات المستعادة.
وعند نحو الساعة 18:00 UTC يوم 1 فبراير 2017، اكتملت إجراءات الاستعادة النهائية، بما فيها استعادة Webhooks والتحقق من أن النظام يعمل كما هو متوقع.
استغرقت عملية التعافي وقتًا طويلًا، ولم يكن بالإمكان استعادة كل البيانات التي أُنشئت بعد اللقطة.
قدّرت GitLab الخسائر بنحو 5,000 مشروع، و5,000 تعليق، و700 حساب مستخدم جديد.
أما مستودعات Git والـ Wikis فلم تُفقد؛ لأنها كانت مخزنة بشكل منفصل عن البيانات التي حُذفت من قاعدة البيانات.
8. ما الذي تعلمته GitLab من الحادثة؟
بعد استعادة الخدمة، لم يقتصر تحليل GitLab على السؤال: «لماذا حذف المهندس البيانات؟».
استخدم الفريق أسلوب The 5 Whys للوصول إلى الأسباب الجذرية للحادثة.
لماذا توقفت الخدمة؟ لأن مجلد بيانات الخادم الأساسي حُذف بالخطأ.
لماذا احتاج الفريق إلى حذف مجلد البيانات؟ لأن النسخ المتماثل توقف، وكان لا بد من إعادة بناء الخادم الثانوي.
لماذا توقف النسخ المتماثل؟ لأن ارتفاع الحمل أدى إلى حذف سجلات WAL قبل أن يتمكن الخادم الثانوي من نسخها.
لماذا ارتفع الحمل؟ بسبب تزامن نشاط مزعج مع مهمة خلفية حاولت حذف حساب موظف بالخطأ.
ثم انتقل الفريق إلى سؤال آخر: لماذا استغرقت الاستعادة كل هذا الوقت؟
كانت الإجابة مرتبطة بفشل النسخ الاحتياطية، وعدم تفعيل لقطات Azure على خوادم قواعد البيانات، وعدم وجود مسؤول واضح عن اختبار إجراءات الاستعادة بانتظام.
هذه النتائج قادت إلى مجموعة من التحسينات، منها:
- تحسين مراقبة النسخ الاحتياطية وإظهار حالات الفشل بوضوح.
- أتمتة اختبارات استعادة النسخ الاحتياطية.
- تحسين توثيق إجراءات التشغيل والنسخ المتماثل.
- توضيح هوية الخوادم وبيئات التشغيل لتقليل احتمالات تنفيذ الأوامر على الخادم الخطأ.
- تحسين إجراءات التعافي من الكوارث وتحديد مسؤولية واضحة عن متانة البيانات.
- زيادة وتيرة إنشاء لقطات LVM إلى مرة كل ساعة بدلًا من مرة كل 24 ساعة، كما ذكرت GitLab ضمن التحسينات التي كانت تعمل عليها وقت نشر المقال.
كان الهدف الأساسي هو تحسين قدرة النظام على التعافي، بدلًا من الاعتماد فقط على منع المهندسين من تنفيذ أوامر معينة.
ما علاقة هذه القصة بكتاب DDIA؟
في فصل Humans and Reliability، يشرح Martin Kleppmann أن وصف الحوادث بأنها «خطأ بشري» لا يكفي لفهم أسبابها.
البشر يصممون الأنظمة ويشغّلونها، وهم قادرون على التكيف والتصرف في الظروف غير المتوقعة. لكن هذه القدرة نفسها تعني أن سلوكهم لا يمكن اختزاله في مجموعة قواعد ثابتة.
في قصة GitLab، وقع الخطأ المباشر عندما حُذفت البيانات من الخادم الأساسي بدلًا من الثانوي.
لكن أثر الخطأ تضخّم بسبب تفاعل عدة عوامل: توثيق غير كافٍ، وسلوك أداة لم يكن واضحًا، ونسخ احتياطية فاشلة، وتنبيهات لم تصل، وغياب اختبارات استعادة منتظمة.
كل مشكلة من هذه المشكلات ساهمت في جعل الحادث أكثر خطورة.
وهنا يظهر مفهوم Blameless Postmortem: مراجعة الحادثة بهدف فهم ما حدث وتحسين النظام، دون اختزال المشكلة في لوم شخص واحد.
هذا لا يعني تجاهل المسؤولية، بل يعني البحث عن الأسباب التقنية والتنظيمية التي سمحت للخطأ بأن يتحول إلى كارثة.
الخلاصة
عندما تصمم نظامًا يعتمد على بيانات مهمة، لا تسأل فقط:
كيف أمنع الخطأ؟
اسأل أيضًا:
هل سأكتشف فشل النسخ الاحتياطي قبل أن أحتاج إليه؟
هل أستطيع استعادة البيانات فعلًا؟
هل توجد خطوات واضحة ومختبرة للتعافي؟
وإذا وقع خطأ بشري، فهل يستطيع النظام احتواء أثره؟
الاعتمادية ليست أن نفترض أن البشر لن يخطئوا، بل أن نصمم أنظمة لا يتحول فيها الخطأ الواحد إلى كارثة يصعب التعافي منها.
المصطلحات التقنية الواردة في القصة
Primary / Secondary: الخادم الأساسي الذي يتعامل مع عمليات قاعدة البيانات، والخادم الثانوي الذي يحتفظ بنسخة من البيانات.
Replication: عملية نقل تغييرات قاعدة البيانات إلى خادم آخر.
Failover: تحويل العمل إلى خادم بديل عند تعطل الخادم الأساسي.
Hot Standby: خادم ثانوي جاهز لاستلام العمل عند الحاجة.
WAL (Write-Ahead Log): سجل تستخدمه PostgreSQL لتسجيل التغييرات، ويساعد في الاستعادة والنسخ المتماثل.
pg_dump: أداة لإنشاء نسخة احتياطية منطقية لقاعدة بيانات PostgreSQL.
pg_basebackup: أداة لإنشاء نسخة أساسية من ملفات قاعدة بيانات PostgreSQL، وتُستخدم ضمن إعداد خادم ثانوي أو إعادة بنائه.
LVM Snapshot: لقطة لحالة وحدات التخزين في وقت معين.
Amazon S3: خدمة تخزين سحابية يمكن استخدامها لحفظ النسخ الاحتياطية.
DMARC: آلية للتحقق من موثوقية رسائل البريد الإلكتروني المرتبطة بنطاق المرسل والمساعدة في الحد من انتحال هويته.
Restore Test: اختبار عملي للتأكد من أن النسخة الاحتياطية قابلة للاستعادة.
Blameless Postmortem: مراجعة للحادثة تهدف إلى فهم الأسباب وتحسين النظام بدلًا من اختزال المشكلة في لوم فرد واحد.
The 5 Whys: أسلوب لتحليل الأسباب الجذرية من خلال تكرار سؤال «لماذا؟» للوصول إلى العوامل الأعمق وراء المشكلة.
المصدر الأساسي: GitLab — Postmortem of database outage of January 31
من كتاب Designing Data-Intensive Applications (DDIA)، فصل Humans and Reliability.S