
في الجزء الأول، تعرفنا على Espresso، قاعدة البيانات الموزعة التي طورتها LinkedIn لتخزين وإدارة بياناتها. وتعرفنا على بنيتها الداخلية وكيف تتعامل مع البيانات وتوزيعها بين الـ Nodes.
في هذا الجزء، سننتقل إلى مجموعة من التحديات التي تواجه أي قاعدة بيانات موزعة: كيف تنقل التغييرات إلى الأنظمة الأخرى؟ كيف تحافظ على تزامن البيانات بين مراكز البيانات؟ وكيف تتعامل مع سقوط إحدى العقد دون فقدان البيانات أو تعطيل النظام بالكامل؟
1. ال Databus: نقل التغييرات إلى الأنظمة الأخرى
تعتمد Espresso على نظام Databus لالتقاط التغييرات التي تحدث داخل قاعدة البيانات ونقلها إلى الأنظمة الأخرى، مع الحفاظ على ترتيب اعتماد العمليات (Commit Order).
يقرأ Databus سجلات المعاملات (Transaction Logs) من Espresso، ويحولها إلى تدفق مستمر من الأحداث (Change Stream).
ويتميز بقدرته على نقل كميات كبيرة من الأحداث (High Throughput)، مع تقليل التأخير في وصول التغييرات (Replication Latency).
تستخدم Espresso هذا النظام في عدة أغراض:
- إرسال التغييرات إلى الأنظمة الأخرى، مثل محركات البحث (Search Indexes) وأنظمة التخزين المؤقت (Caches).
- نقل التغييرات بين مراكز البيانات المختلفة (Datacenters)، بحيث يتم إرسال كل عملية كتابة حدثت في مركز بيانات إلى المراكز الأخرى.
2. الData Replicator: مزامنة البيانات بين مراكز البيانات
تحتاج LinkedIn إلى الحفاظ على تزامن البيانات بين نسخ Espresso الموجودة في مراكز بيانات مختلفة.
لهذا الغرض، تستخدم خدمة تسمى Data Replicator.
تعمل هذه الخدمة باعتبارها مستهلكًا (Consumer) لنظام Databus؛ فهي تقرأ الأحداث الخاصة بكل Partition وتنقلها إلى Espresso Cluster الموجود في مركز البيانات الآخر.
تحسين كفاءة النقل باستخدام Batching
قد تكون المسافة بين مراكز البيانات كبيرة، مما يؤدي إلى ارتفاع زمن انتقال البيانات عبر الشبكة (Network Latency).
لتقليل تأثير ذلك، تجمع Data Replicator مجموعة من الأحداث الخاصة بكل Partition وترسلها معًا (Batching)، بدلًا من إرسال كل حدث بصورة منفصلة.
يساعد ذلك على تحسين معدل نقل البيانات (Throughput)، خاصة عند الاتصال عبر شبكات ذات زمن انتقال مرتفع.
كيف تتعامل الخدمة مع الأعطال؟
تتكون Data Replicator من مجموعة من النسخ (Instances) التي تديرها Apache Helix.
هذه النسخ Stateless، أي أنها لا تعتمد على الاحتفاظ بحالة تقدم عملية نقل البيانات محليًا.
بدلًا من ذلك، يقوم كل Databus Consumer بحفظ نقطة التقدم (Checkpoint) بصورة دورية في ZooKeeper.
يحتوي الـ Checkpoint على آخر نقطة وصل إليها Consumer في عملية نقل التغييرات.
ماذا يحدث إذا تعطلت إحدى النسخ؟
- تكتشف Helix تعطل الـ Node.
- تعيد توزيع الـ Partitions التي كانت مسؤولة عنها على النسخ المتبقية.
- تبدأ النسخة الجديدة معالجة الـ Partitions من آخر Checkpoint محفوظ في ZooKeeper.
- تستكمل نقل التغييرات من النقطة التي توقفت عندها النسخة السابقة.
بهذه الطريقة، لا يؤدي سقوط إحدى العقد أو إعادة تشغيل الخدمة إلى فقدان تقدم عملية Replication.
3. الSnapshot Service: إنشاء نسخ من البيانات دون الضغط على قاعدة البيانات
يحتاج معظم مستخدمي Espresso داخل LinkedIn إلى نقل البيانات تلقائيًا إلى HDFS، وهو نظام تخزين موزع ضمن منظومة Hadoop، يُستخدم لتخزين ومعالجة كميات ضخمة من البيانات.
تُستخدم هذه البيانات في عمليات التحليل والمعالجة (ETL).
لكن هناك تحديًا: كيف ننقل جميع بيانات Espresso إلى HDFS دون التأثير بشكل كبير على قاعدة البيانات الأساسية المسؤولة عن خدمة طلبات المستخدمين (Serving Cluster)؟
لحل هذه المشكلة، طورت LinkedIn خدمة Snapshot Service.
كيف تعمل Snapshot Service؟
تأخذ Espresso نسخًا احتياطية دورية (Periodic Backups) من البيانات، وتكتبها في مساحة تخزين مشتركة يمكن لجميع العقد داخل مركز البيانات الوصول إليها.
كما تحفظ معلومات عن النسخ الاحتياطية الحديثة (Backup Metadata) في ZooKeeper.
تقوم Snapshot Service بمراقبة هذه المعلومات باستخدام Watch على الـ Znodes.
عندما يتم إنشاء نسخة احتياطية جديدة، تتلقى الخدمة إشعارًا بذلك، ثم:
- تستعيد النسخة الاحتياطية محليًا (Restore).
- تنتج ملفات Avro منفصلة لكل Table داخل قاعدة البيانات.
- تصبح هذه الملفات متاحة لخدمة أخرى تسمى Puller، لتقوم بتحميلها إلى HDFS.
وهناك فائدة إضافية لهذه العملية: يتم التحقق من سلامة النسخ الاحتياطية (Backup Validation) بمجرد إنشائها، لأن الخدمة تقوم باستعادتها بالفعل.
استخدام آخر: Databus Bootstrap Files
لا تقتصر أهمية Snapshot Service على نقل البيانات إلى HDFS.
فهي تساعد أيضًا في حل مشكلة تواجه مستهلكي Databus.
يحتفظ Databus بعدد محدود من الأحداث في الذاكرة (Fixed-size Buffer).
لذلك، إذا بدأ Consumer جديد العمل، أو توقف Consumer لفترة طويلة، فقد يجد أن بعض الأحداث التي يحتاج إليها لم تعد موجودة في Databus.
كيف يمكنه استعادة البيانات التي فاتته؟
تنتج Snapshot Service ملفات Avro يمكن استخدامها لتهيئة Databus Consumer، وتزويده بصورة صحيحة عن البيانات عند نقطة زمنية معينة.
بعد ذلك، يستطيع Consumer متابعة استقبال التغييرات الجديدة من Databus.
بمعنى آخر، بدلًا من محاولة استعادة جميع التغييرات القديمة من الذاكرة، يمكنه البدء من Snapshot ثم متابعة الأحداث اللاحقة لها.
ومن الجدير بالذكر أن Snapshot Service نفسها نظام موزع، وتستخدم نموذج Online-Offline لإدارة حالاتها، مثل Data Replicator.
4. واجهة التعامل مع البيانات (API)
توفر Espresso واجهة RESTful مبنية على HTTP للتعامل مع المستندات (Documents).
تستخدم PUT للإضافة أو الاستبدال الكامل، وPOST للتحديث الجزئي أو الإضافة بمفتاح تلقائي، وGET للقراءة، وDELETE للحذف. كما تدعم العمليات الشرطية باستخدام ETag وLast-Modified.
5. ال SCN: الساعة الداخلية لترتيب الأحداث
في الأنظمة الموزعة، لا يكفي معرفة أن عملية معينة حدثت؛ بل نحتاج أيضًا إلى معرفة ترتيب حدوثها.
تزداد أهمية ذلك عند نقل التغييرات بين مراكز البيانات أو إرسالها إلى Databus.
لهذا تستخدم Espresso آلية داخلية لترتيب الأحداث تسمى:
System Change Number (SCN)
كل عملية تعديل ناجحة (Insert أو Update أو Delete) تحصل على رقم SCN مكون من 64 بت.
هذا الرقم يزداد باستمرار، وتحتفظ كل Partition بالرقم الخاص بها بشكل مستقل.
مم يتكون SCN؟
يتكون الرقم من جزأين:
- Generation: أول 32 بت (Higher 32 bits).
- Sequence: آخر 32 بت (Lower 32 bits).
كل Transaction يتم اعتمادها (Commit) تزيد قيمة Sequence بمقدار 1.
أما عند انتقال مسؤولية الـ Master من Node إلى أخرى (Mastership Transition)، فتزيد قيمة Generation بمقدار 1، وتبدأ Sequence من جديد.
والأحداث التي يتم اعتمادها ضمن نفس Transaction تشترك في نفس SCN.
يتم إنشاء SCN حاليًا بواسطة MySQL عند اعتماد المعاملة.
مثال: ماذا يحدث عند سقوط الـ Master؟
لنفترض أن لدينا عقدتين تستضيفان Partition رقم 0:
- N1: تعمل كـ Master.
- N2: تعمل كـ Slave.
في البداية، قيمة SCN هي:
(1, 1)
حيث Generation تساوي 1 وSequence تساوي 1.
إذا استقبلت N1 ثلاث عمليات كتابة، تصبح قيمة SCN:
(1, 4)
الآن افترض أن N1 تعرضت لعطل، وأصبحت N2 هي الـ Master الجديدة.
تقرأ N2 آخر قيمة SCN، وهي (1, 4)، ثم تزيد Generation وتعيد Sequence إلى البداية:
(2, 1)
بهذا نستطيع التمييز بين الأحداث التي حدثت في فترة الـ Master القديمة والأحداث التي حدثت بعد انتقال المسؤولية إلى الـ Master الجديدة.
لماذا يتم إدارة SCN لكل Partition؟
لأن الـ Partitions ليست مرتبطة بشكل دائم بـ MySQL Instance معينة.
أثناء توسيع النظام (Expansion)، قد تنتقل Partition من Node إلى أخرى.
لذلك، لو كان SCN مرتبطًا بـ MySQL Instance، فقد تصبح إدارة ترتيب الأحداث معقدة عند نقل الـ Partitions.
الحل هو أن تحتفظ كل Partition بالـ SCN الخاص بها، بغض النظر عن الـ Node التي تستضيفها.
6. ال Schema Management: إدارة تعريفات البيانات
تحتفظ Espresso بتعريفات الـ Schemas داخل ZooKeeper، ويُستخدم هذا المكون بشكل مشترك بين خدمات Espresso المختلفة.
عند إضافة Schema جديدة باستخدام PUT:
- يتم حفظ تعريفها في ZooKeeper.
- يتم نشرها إلى جميع Storage Nodes.
أما عند حذف تعريف Table أو Database Schema، فيتم حذفه من ZooKeeper، وتقوم جميع Storage Nodes بحذف البيانات المرتبطة به.
ونظرًا لخطورة هذه العملية، تسمح Espresso بتعطيل حذف الـ Schemas من خلال الإعدادات.
وبالفعل، عطّلت LinkedIn عمليات حذف الـ Schemas في جميع بيئات Production، كإجراء احترازي لمنع حذف مجموعات البيانات التي تعتمد عليها خدمات المستخدمين بالخطأ.
7. ال Schema Evolution: تطوير بنية البيانات دون كسر التوافق
تسمح Espresso بتطوير تعريفات المستندات (Document Schemas) وفقًا لقواعد تطور Avro Schema Evolution، مع وجود بعض القيود الإضافية الخاصة بـ Espresso.
وتسمح بتغييرات غير متوافقة مع الإصدارات القديمة (Backward Incompatible Changes)، لكنها لا تشجع عليها.
مثال: إضافة حقل جديد
لنفترض أن لدينا Schema لمستندات Messages، ونريد إضافة حقل جديد باسم:
senderName
سيصبح لدينا إصدار جديد من الـ Schema.
جميع السجلات الجديدة ستُسلسل باستخدام أحدث إصدار تلقائيًا، ما لم يحدد الطلب إصدارًا آخر.
لكن ماذا عن المستندات القديمة؟
بما أن الحقل الجديد اختياري (Optional)، يمكن ترقية قراءة المستندات القديمة التي تم تخزينها باستخدام Schema Version 1 إلى Schema Version 2.
أي أن المستندات القديمة تظل قابلة للقراءة رغم أنها لا تحتوي على الحقل الجديد.
وهذه هي الفكرة الأساسية من Schema Evolution: تطوير بنية البيانات مع الحفاظ على القدرة على التعامل مع البيانات الموجودة بالفعل.
8. ال Fault Tolerance: كيف تتعامل Espresso مع سقوط إحدى العقد؟
تعتمد Espresso على Apache Helix لإدارة الـ Cluster وتوزيع الأدوار بين العقد.
وبما أن Storage Nodes هي المصدر الأساسي للبيانات (Source of Truth)، فإن التعامل مع الأعطال بشكل صحيح أمر بالغ الأهمية.
كل Node يمكن أن تستضيف Partitions تعمل كـ Master وأخرى تعمل كـ Slave.
ماذا يحدث عند سقوط Node؟
تمر عملية التعافي بعدة خطوات:
- عند اتصال Storage Node بـ Helix، تنشئ عقدة مؤقتة (Ephemeral Node) داخل ZooKeeper، وتراقب Helix وجودها.
- إذا تعطلت الـ Node أو فقدت الاتصال أو توقفت عن الاستجابة للـ Heartbeats، يقوم ZooKeeper بحذف الـ Ephemeral Node.
- تكتشف Helix العطل وتحدّث External View لاستبعاد العقدة المتعطلة.
- تعيد Helix حساب توزيع الأدوار، وتصدر انتقالات الحالة (State Transitions).
- تتحول إحدى نسخ الـ Slave للـ Partitions المتأثرة إلى Master.
هل تتوقف الخدمة أثناء التعافي؟
أثناء عملية الانتقال، توجد فترة قصيرة قد لا تكون فيها عمليات الكتابة متاحة.
يحدث ذلك عندما لا تكون هناك Master مسؤولة عن Partition معينة؛ ففي هذه الحالة لا يمكن اعتماد عمليات كتابة جديدة عليها.
لكن بما أن النظام يحتفظ بنسخة Slave واحدة على الأقل، يستطيع الـ Router اكتشاف هذه الحالة وتوجيه طلبات القراءة إلى نسخ الـ Slave.
وبالتالي، يمكن أن تظل بعض عمليات القراءة متاحة حتى أثناء فترة التعافي.
مثال: سقوط Node داخل Cluster
لنفترض أن لدينا:
- 4 Storage Nodes.
- قاعدة بيانات مقسمة إلى 12 Partition.
- لكل Partition نسختان: Master وSlave.
في الحالة الطبيعية، تكون كل Node مسؤولة عن:
- 3 Partitions كـ Master.
- 3 Partitions كـ Slave.
أي أن كل Node تستضيف 6 نسخ من الـ Partitions.
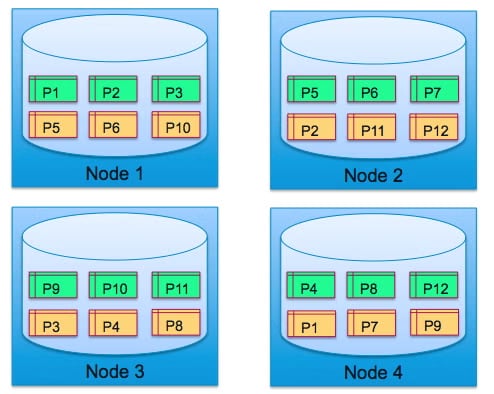
الآن، إذا تعطلت Node رقم 3، فإن Partitions رقم 9 و10 و11 ستفقد الـ Master الخاصة بها.
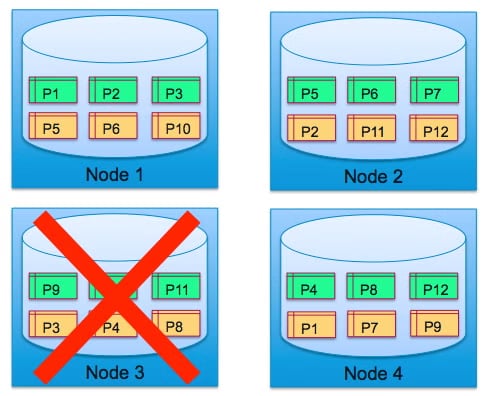
تتدخل Helix وتحوّل نسخ الـ Slave المقابلة لهذه الـ Partitions إلى Master.
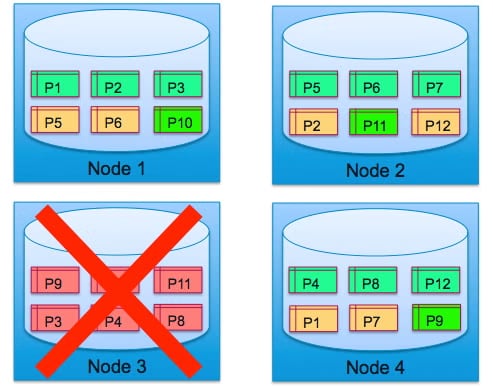
وبذلك يستعيد النظام قدرته على استقبال عمليات الكتابة دون الحاجة إلى إعادة بناء البيانات من الصفر.
9. Backup Restore: استعادة البيانات والتعافي من الأعطال
تستطيع Storage Nodes في Espresso أخذ نسخ احتياطية دورية من جميع الـ Partitions التي تستضيفها.
تُضغط هذه النسخ (Compressed Backup Images)، ثم تُرسل إلى نظام ملفات موزع (Distributed File System).
والنقطة المهمة أن النسخ الاحتياطية تُنتج لكل Partition بشكل مستقل، وليس لكل Node.
والسبب هو أن الـ Partitions قد تنتقل بين العقد أثناء توسيع النظام (Expansion).
ما المعلومات الموجودة داخل النسخة الاحتياطية؟
تحتوي كل نسخة احتياطية على رقم SCN الخاص بالـ Partition وقت أخذ النسخة.
وهذا الرقم مهم جدًا؛ لأنه يحدد آخر تغيير تم تضمينه في النسخة الاحتياطية.
كيف تتم عملية الاستعادة؟
يمكن استخدام النسخ الاحتياطية في عدة حالات:
- استعادة البيانات عند سقوط إحدى العقد.
- إنشاء Cluster جديد وتهيئته بالبيانات.
- توسيع Cluster موجود وإضافة عقد جديدة.
بعد استعادة النسخة الاحتياطية، تبدأ الـ Node في اللحاق بالتغييرات (Catch-up) التي حدثت بعد وقت أخذ النسخة.
وتستخدم قيمة SCN الموجودة في النسخة لتحديد نقطة البداية، ثم تستكمل تطبيق التحديثات اللاحقة لها.
وبذلك لا نحتاج إلى إعادة تحميل كل البيانات من البداية عند استعادة النظام.
الخلاصة: كيف تتكامل هذه المكونات؟
يمكننا تلخيص أهم المكونات التي تعرفنا عليها في هذا الجزء كالتالي:
| المكون | المسؤولية الأساسية |
|---|---|
| Databus | التقاط التغييرات ونقلها إلى الأنظمة الأخرى |
| Data Replicator | نقل التغييرات بين مراكز البيانات |
| Helix | إدارة العقد وتوزيع الـ Partitions |
| ZooKeeper | حفظ معلومات التنسيق والحالة والـ Checkpoints |
| Snapshot Service | إنتاج نسخ من البيانات وتحويلها إلى ملفات Avro |
| SCN | ترتيب التغييرات داخل كل Partition |
| Schema Evolution | تطوير بنية البيانات مع الحفاظ على التوافق |
| Backup Restore | استعادة البيانات واللحاق بالتغييرات اللاحقة |
ما تكشفه هذه المكونات هو أن بناء قاعدة بيانات موزعة لا يتوقف عند تقسيم البيانات على عدة Servers.
التحدي الحقيقي هو إدارة دورة حياة البيانات بالكامل: من لحظة كتابتها، إلى نقلها، وتوزيعها، واستعادتها عند الأعطال، وتطوير بنيتها مع استمرار النظام في العمل.
وهذا ما يجعل فهم الأنظمة الموزعة قائمًا على فهم العلاقات بين مكوناتها، وليس مجرد معرفة وظيفة كل مكون بصورة منفصلة.