
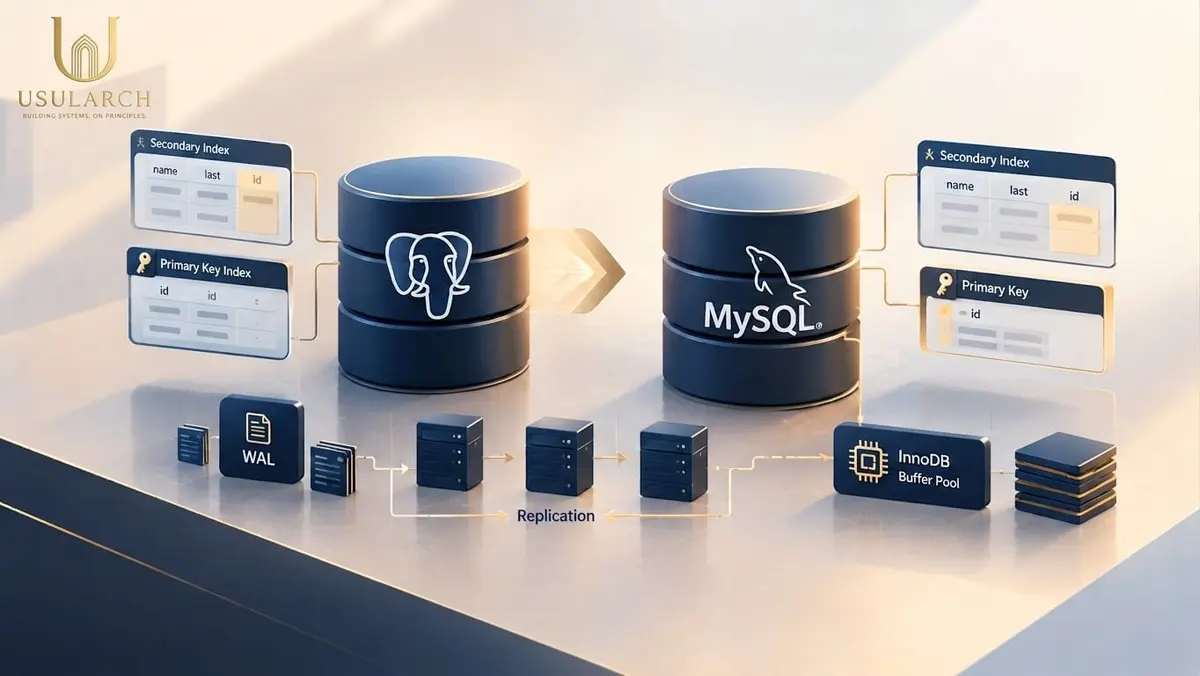
في الجزء الأول (أقرأ من هنا)، رأينا كيف يمكن لتحديث صف واحد في PostgreSQL أن يؤدي إلى عدة عمليات كتابة على مستوى الجدول والفهارس، وكيف يمكن أن ينعكس ذلك على حجم البيانات المتبادلة بين قواعد البيانات.
لكن المشكلة لم تكن مجرد عدد عمليات الكتابة.
كانت Uber تبحث عن بنية تستطيع التعامل مع نمو البيانات، وتقلّل تكلفة التحديثات، وتسهّل نسخ البيانات وترقية قواعد البيانات.
في مقالها المنشور عام 2016، شرحت الشركة لماذا وجدت أن MySQL، باستخدام محرك التخزين InnoDB، أنسب لعدد من احتياجاتها.
لفهم هذا القرار، سنبدأ من المكان نفسه الذي بدأنا منه في الجزء الأول: كيف تُمثَّل البيانات والفهارس داخل قاعدة البيانات؟
1. InnoDB: اختلاف صغير في تصميم الفهارس
لفهم الاختلاف، لنعد إلى جدول المستخدمين الذي استخدمناه في الجزء السابق:
| id | first | last | birth_year |
|---|---|---|---|
| 1 | Blaise | Pascal | 1623 |
| 4 | Muhammad | al-Khwārizmī | 780 |
| 5 | Alan | Turing | 1912 |
لنفترض أن لدينا ثلاثة فهارس:
- Primary Key على
id. - Secondary Index على
(first, last). - Secondary Index على
birth_year.
في PostgreSQL، تشير إدخالات الفهارس مباشرةً إلى مواقع الصفوف داخل الجدول، التي يحددها ctid.
أما في InnoDB، فالتصميم مختلف.
يستخدم InnoDB ما يُسمّى Clustered Index لتخزين بيانات الصفوف وترتيبها وفق المفتاح الأساسي (Primary Key). ويحتوي الـ Primary Key Index على بيانات الصفوف نفسها، وليس مجرد مؤشرات إلى مواقعها.
أما الـ Secondary Indexes، فلا تشير مباشرةً إلى الموقع الفيزيائي للصف، بل تحتفظ بقيمة المفتاح الأساسي الخاص به.
يمكن تمثيل فهرس الاسم بالشكل التالي:
| first | last | id |
|---|---|---|
| Ada | Lovelace | 7 |
| Alan | Turing | 5 |
| Blaise | Pascal | 1 |
| Muhammad | al-Khwārizmī | 4 |
لاحظ أن الفهرس يحتوي على الاسم، ومعه id الذي يسمح بالوصول إلى الصف الأصلي.
ما ثمن هذا التصميم؟
إذا أردنا البحث عن مستخدم باستخدام اسمه، فإن InnoDB يبحث أولًا في الـ Secondary Index للحصول على المفتاح الأساسي، ثم يستخدم المفتاح الأساسي للوصول إلى الصف.
أي إن عملية البحث قد تتطلب خطوتين:
- البحث في Secondary Index.
- البحث في Clustered Index باستخدام المفتاح الأساسي.
في المقابل، يستطيع PostgreSQL الوصول إلى الصف عبر الفهرس الذي يشير مباشرةً إلى موقع الـ Tuple، مع مراعاة متطلبات الرؤية الخاصة بـ MVCC.
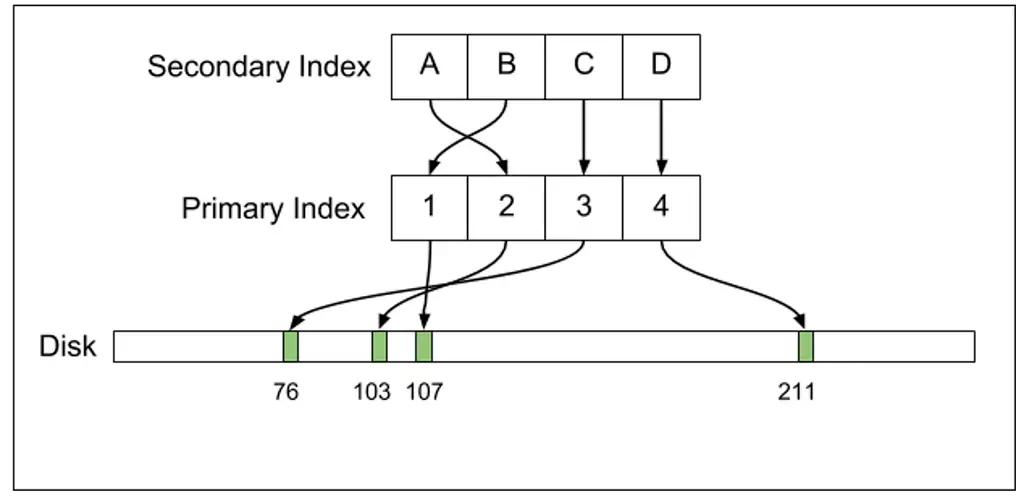
إذًا، تصميم InnoDB ليس أفضل في كل شيء؛ فقد يتطلب الوصول إلى صف عبر Secondary Index عملية بحث إضافية.
لكن هذا الاختلاف يحقق ميزة مهمة عند تحديث البيانات.
2. لماذا يمكن أن يصبح تحديث الصف أقل تكلفة؟
لنفترض أننا نريد تعديل سنة ميلاد المستخدم صاحب id = 4:
UPDATE users
SET birth_year = 770
WHERE id = 4;
في InnoDB، يمكن تحديث قيمة birth_year داخل الصف نفسه، وفي هذا المثال تحديدًا، لأن العمود من نوع Integer ذي الحجم الثابت.
كما يُحدَّث المدخل الخاص بهذا الصف في فهرس birth_year.
أما فهرس المفتاح الأساسي (primary key)، فلا يحتاج إلى التحديث؛ لأن قيمة id لم تتغير.
وفهرس الاسم لا يحتاج إلى التحديث أيضًا، لأن قيمتي first وlast لم تتغيرا، ولأن هذا الفهرس يشير إلى المفتاح الأساسي بدلًا من الموقع الفيزيائي للصف.
ماذا يحدث للنسخة القديمة التي قد تحتاج إليها معاملة أخرى؟
يحتفظ InnoDB بمعلومات النسخة السابقة في منطقة خاصة تُسمّى Rollback Segment، حتى تتمكن آلية MVCC من توفير النسخة المناسبة للمعاملات التي تحتاج إليها.
قارن ذلك بما رأيناه في PostgreSQL: عندما يتطلب التحديث إنشاء نسخة جديدة من الـ Tuple، قد تحتاج الفهارس إلى إدخالات جديدة تشير إلى موقعها الجديد.
أما في InnoDB، فإن تحديث عمود واحد لا يستلزم تحديث الفهارس التي تعتمد على أعمدة لم تتغير.
تخيّل جدولًا يحتوي على فهارس إضافية لتاريخ التسجيل وآخر تسجيل دخول والمنطقة الجغرافية.
إذا غيّرنا سنة الميلاد فقط، فلن نحتاج إلى تحديث تلك الفهارس ما دامت أعمدتها المفهرسة لم تتغير، ولم تتغير قيمة المفتاح الأساسي.
الدرس هنا ليس أن InnoDB يلغي تكلفة الكتابة، بل أن تصميم الفهارس يؤثر في عدد التغييرات اللازمة لتنفيذ عملية تحديث.
وهذا قد يصبح فارقًا كبيرًا في الجداول التي تحتوي على عدد كبير من الفهارس وتتعرض لعمليات كتابة كثيفة.
3. من تصميم الفهارس إلى تصميم Replication
حتى الآن، ركّزنا على ما يحدث داخل قاعدة البيانات.
لكن إحدى المشكلات المهمة التي واجهتها Uber كانت نقل التغييرات إلى النسخ التابعة (Replicas).
لفهم الفرق، علينا التمييز بين نوعين من النسخ المتماثل في MySQL.
Statement-Based Replication
في هذا النمط، تُنقل أوامر SQL نفسها إلى النسخة التابعة.
على سبيل المثال، يمكن أن يكون التغيير المنقول:
UPDATE users
SET birth_year = 770
WHERE id = 4;
تستقبل النسخة التابعة الأمر وتنفذه على بياناتها.
الميزة أن هذا النمط قد يكون أقل حجمًا من نقل جميع التغييرات الفعلية الناتجة عن تنفيذ الأمر.
لكن له تنازلات؛ إذ قد تضطر النسخة التابعة إلى تنفيذ استعلام مكلف حتى لو كان التغيير النهائي صغيرًا، كما تتطلب بعض الأوامر عناية خاصة لضمان اتساق النتائج.
Row-Based Replication
في هذا النمط، تُنقل التغييرات التي طرأت على الصفوف، بدلًا من الاعتماد على إعادة تنفيذ أمر SQL الأصلي.
قد يكون هذا النمط أكبر حجمًا من Statement-Based Replication، لكنه يوفّر سلوكًا أكثر قابلية للتوقع في حالات كثيرة.
ويدعم MySQL أيضًا Mixed Replication، الذي يجمع بين النمطين.
لكن النقطة الأهم في تجربة Uber لا تتعلق باسم النمط وحده، بل بالفرق بين ما تسجله قاعدة البيانات وما تحتاج إلى نقله إلى النسخ التابعة.
لماذا اختلفت Uber مع PostgreSQL؟
كما رأينا في الجزء الأول، يستخدم PostgreSQL سجلات WAL التي تتضمن معلومات عن التغييرات على مستوى التخزين الفعلي.
أما في بنية MySQL التي يشرحها المقال، فيمكن لسجل النسخ المتماثل أن يعبّر عن التغييرات على مستوى الصفوف، بينما تتولى النسخة التابعة تنفيذ التغييرات اللازمة على فهارسها.
على سبيل المثال، يمكن أن يكون المعنى المنطقي للتغيير هو: تحديث سنة ميلاد المستخدم الذي يحمل المفتاح الأساسي 4.
لا تحتاج النسخة التابعة إلى تلقي وصف منفصل لكل تغيير داخلي في بنية الفهرس؛ إذ يستنتج محرك قاعدة البيانات التغييرات اللازمة عند تطبيق التحديث.
لهذا، وجدت Uber أن سجل النسخ المتماثل في MySQL أكثر اختصارًا من سجل WAL في PostgreSQL في حالات الاستخدام التي ناقشتها.
وهذا مهم عندما تكون هناك كميات كبيرة من البيانات التي يجب نقلها عبر مسافات جغرافية بعيدة أو أرشفتها لاستعادة البيانات لاحقًا.
لكن ينبغي الانتباه إلى أن المقارنة هنا ليست بين كل أشكال Replication الممكنة في النظامين؛ بل بين آليات النسخ التي اعتمدت عليها Uber في تلك التجربة.
4. ماذا عن المعاملات الطويلة على النسخ التابعة؟
هناك اختلاف آخر يرتبط بآلية MVCC وطريقة تطبيق التغييرات على النسخ التابعة.
في PostgreSQL، تعتمد Streaming Replication على تطبيق سجلات WAL التي تعكس التغييرات الفيزيائية. وقد يتعارض تطبيق بعض هذه التغييرات مع معاملات قراءة طويلة تعمل على النسخة التابعة.
إذا حدث ذلك، فقد يتوقف تطبيق التغييرات مؤقتًا، مما يؤدي إلى تأخر النسخة التابعة عن الخادم الأساسي. وقد تنتهي المشكلة بإنهاء معاملة القراءة إذا استمر التعارض وتجاوز المهلة المحددة.
أما في MySQL، فإن النسخ المتماثل المنطقي يتيح فصلًا مختلفًا بين وصف التغييرات وطريقة تطبيقها داخل محرك التخزين.
وفقًا لتحليل Uber، ساعد هذا التصميم على توفير سلوك أفضل لعمليات القراءة على النسخ التابعة، دون الحاجة إلى إيقاف تطبيق سجل التغييرات بالطريقة نفسها التي وصفتها الشركة في PostgreSQL.
لكن ذلك لا يعني أن النسخ التابعة في MySQL لا تتأخر مطلقًا، أو أن المعاملات لا يمكن أن تتعارض؛ فالأداء يعتمد على نمط النسخ، والحمل، والإعدادات، وطبيعة الاستعلامات.
5. لماذا اهتمت Uber بطريقة التخزين المؤقت؟
بعد مناقشة تخزين البيانات والنسخ المتماثل، ينتقل المقال إلى اختلاف آخر: إدارة الذاكرة.
عندما يطلب التطبيق بيانات من قاعدة البيانات، فإن الوصول إلى القرص في كل مرة سيكون مكلفًا. لذلك تستفيد قواعد البيانات من الذاكرة للاحتفاظ بالصفحات التي يجري الوصول إليها بصورة متكررة.
في PostgreSQL: الاعتماد على Page Cache
في التصميم الذي وصفته Uber، يستفيد PostgreSQL من ذاكرة النظام التي يديرها Linux، والمعروفة باسم Page Cache، للاحتفاظ ببيانات الملفات التي جرى الوصول إليها مؤخرًا.
وقد أوضح المقال أن بعض خوادم PostgreSQL لدى Uber كانت تمتلك ذاكرة كبيرة، لكن جزءًا محدودًا منها كان مستخدمًا مباشرةً بواسطة عمليات PostgreSQL، بينما استفادت بقية الذاكرة من Page Cache الخاصة بالنظام.
من وجهة نظر الشركة، كانت هناك تكلفة مرتبطة بالوصول إلى البيانات عبر هذه الآلية، لأن العملية قد تحتاج إلى تنفيذ استدعاءات نظام للوصول إلى البيانات وقراءتها.
ال InnoDB: Buffer Pool
أما InnoDB، فيدير ذاكرة التخزين المؤقت الخاصة به، والتي تُسمّى InnoDB Buffer Pool.
تحتفظ هذه المنطقة بصفحات البيانات والفهارس التي يجري استخدامها، وتستخدم آليات لإدارة الصفحات (pages) التي ينبغي الاحتفاظ بها أو استبدالها.
ومن مزايا هذا التصميم أن InnoDB يستطيع التحكم في سياسة إدارة الصفحات (pages) بصورة مخصصة، والتعامل مع أنماط الوصول التي قد تقلل فعالية سياسة التخزين المؤقت التقليدية.
كما يمكن أن يقلل الوصول إلى البيانات الموجودة في Buffer Pool من الحاجة إلى بعض عمليات الانتقال بين وضع المستخدم (user) ووضع النواة (kernel ).
6. إدارة الاتصالات: Process مقابل Thread
يناقش المقال أيضًا طريقة التعامل مع اتصالات العملاء المتزامنة.
في PostgreSQL 9.2، كان كل اتصال نشط يعتمد عادةً على عملية مستقلة (Process).
أما MySQL، فكان يستخدم نموذج Thread لكل اتصال في البنية التي تناولها المقال.
لكل نموذج تكاليفه وخصائصه.
ال process المستقلة قد تستهلك موارد إضافية مقارنة بال (Threads)، كما أن التواصل بين العمليات (process) قد يكون أكثر تكلفة من التواصل بين الخيوط (threads) داخل العملية نفسها.
وفي تجربة Uber، واجهت الشركة صعوبات في توسيع PostgreSQL إلى أعداد كبيرة من الاتصالات النشطة، بينما وجدت أن MySQL قادر على التعامل مع أعداد أكبر في بيئتها.
لكن هذا لا يعني أن إنشاء Thread لكل اتصال بلا تكلفة، ولا أن PostgreSQL لا يستطيع دعم أعداد كبيرة من الاتصالات عبر تصميم مناسب.
فعلى سبيل المثال، يمكن استخدام Connection Pooling لتقليل عدد الاتصالات الفعلية بقاعدة البيانات. وقد أشارت Uber نفسها إلى نجاح استخدام PgBouncer في بعض الحالات، مع استمرار وجود تحديات تشغيلية مرتبطة بالاتصالات الطويلة أو التي تبقى مفتوحة دون حاجة.
الخلاصة: لا تختَر قاعدة البيانات من اسمها
إذا قارنا التصميمين، فسنجد أن PostgreSQL وInnoDB يقدّمان آليات مختلفة لتخزين الصفوف، وربط الفهارس بالبيانات، وتطبيق التغييرات على النسخ التابعة.
في التصميم الذي ناقشته Uber، كان من الممكن أن يؤدي تحديث صف في PostgreSQL إلى تغييرات إضافية على عدة فهارس، بينما سمح تصميم InnoDB بتحديث الفهارس المتأثرة فقط في الحالات المناسبة.
كما وجدت Uber مزايا في طريقة النسخ المتماثل، وإدارة الذاكرة، والتعامل مع الاتصالات في بيئتها.
لكن الدرس الأهم ليس أن MySQL هو الاختيار الصحيح لكل نظام.
بل أن اختيار قاعدة البيانات يجب أن يبدأ من فهم طبيعة الحمل، ومتطلبات الاتساق، وتكلفة القراءة والكتابة، وطريقة النسخ المتماثل، والقيود التشغيلية.
الأدوات ليست قرارات معمارية جاهزة؛ بل خيارات لها خصائص وتنازلات، ويجب تقييمها في سياق النظام الذي نبنيه.
قاموس المصطلحات
InnoDB: محرك التخزين الأكثر شيوعًا مع MySQL، ويدعم المعاملات وMVCC والفهارس.
Clustered Index: فهرس تُخزَّن بيانات الصفوف نفسها ضمن بنيته، ويُرتَّب وفق المفتاح الأساسي في InnoDB.
Rollback Segment: منطقة يحتفظ فيها InnoDB بمعلومات النسخ السابقة للصفوف اللازمة لدعم التراجع وMVCC.
Statement-Based Replication: نسخ يعتمد على نقل أوامر SQL وإعادة تنفيذها على النسخ التابعة.
Row-Based Replication: نسخ يعتمد على تسجيل التغييرات التي طرأت على الصفوف ونقلها إلى النسخ التابعة.
Buffer Pool: ذاكرة يديرها InnoDB للاحتفاظ بصفحات البيانات والفهارس المستخدمة بكثرة.
Page Cache: ذاكرة يديرها نظام التشغيل للاحتفاظ بمحتويات ملفات جرى الوصول إليها مؤخرًا.
Connection Pooling: إعادة استخدام مجموعة من الاتصالات بقاعدة البيانات لتقليل تكلفة إنشاء الاتصالات وإدارتها.
Schemaless: طبقة تخزين وتقسيم بيانات بنتها Uber فوق MySQL لدعم احتياجات منصتها.
Trade-off: مفاضلة هندسية بين مزايا وعيوب، مثل تحسين تكلفة الكتابة مقابل زيادة عدد عمليات البحث اللازمة للقراءة.